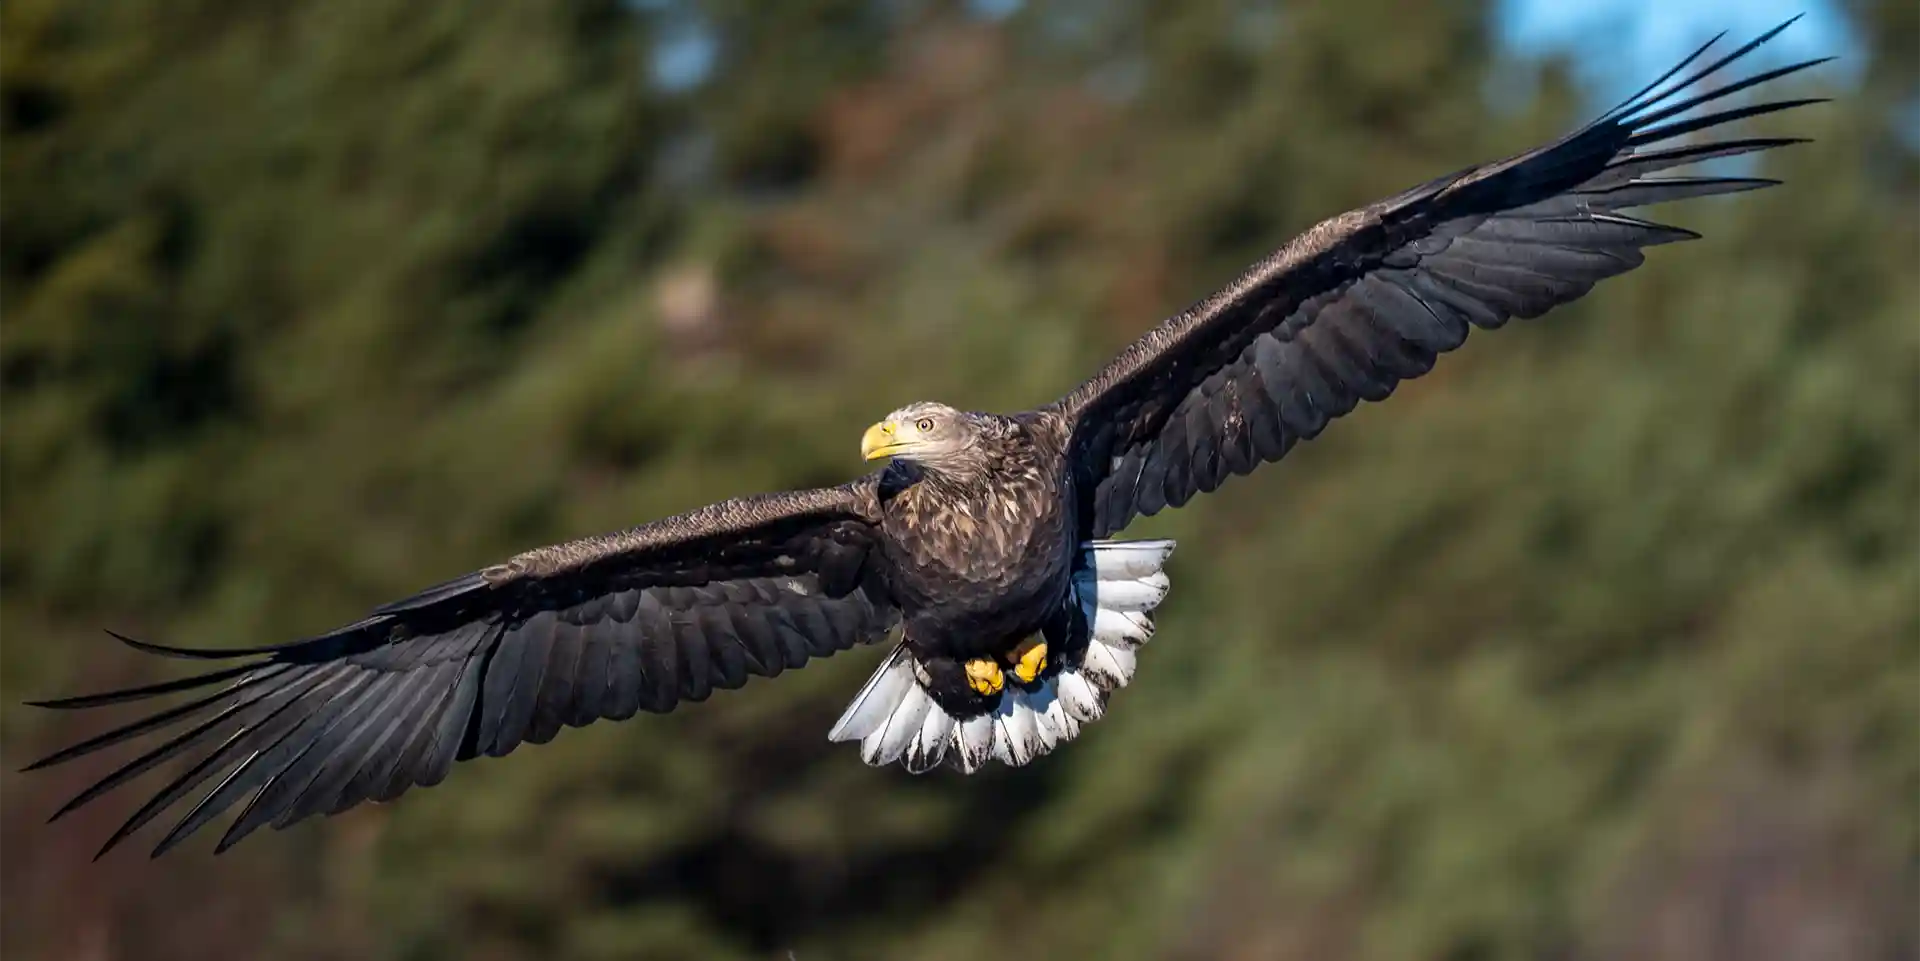
En liten kriminalhistoria om upphovsrätt, bildfiler och en fotograf som plötsligt hamnade under lupp.
Jag har arbetat som fotograf i över 35 år. Under den tiden har jag pratat en hel del om hur viktigt det är att fotografier innehåller rätt information. Fotografens namn, bildtext, upphovsrätt och annan metadata ska följa med bilden. Det är självklart för mig.
Eller?
När jag började granska bilderna på min egen webbplats, RVBild, dök en ganska obekväm fråga upp: Har jag själv slarvat med det jag brukar uppmana andra fotografer att sköta ordentligt?
Plötsligt var fotografen misstänkt
Det började med att WordPress visade tomma fält för fotograf och copyright på några av mina bilder. Hade jag glömt att fylla i uppgifterna? Fanns informationen i originalet men inte i webbfilen? Eller hade något hänt under bildbehandlingen?
Det fanns flera misstänkta. Photoshop, webbexporten, WordPress och tillägg för bildoptimering. Och så förstås fotografen själv. Det sista alternativet kändes inte alldeles bekvämt.
Kungsörnen, skatan och den försvunna informationen
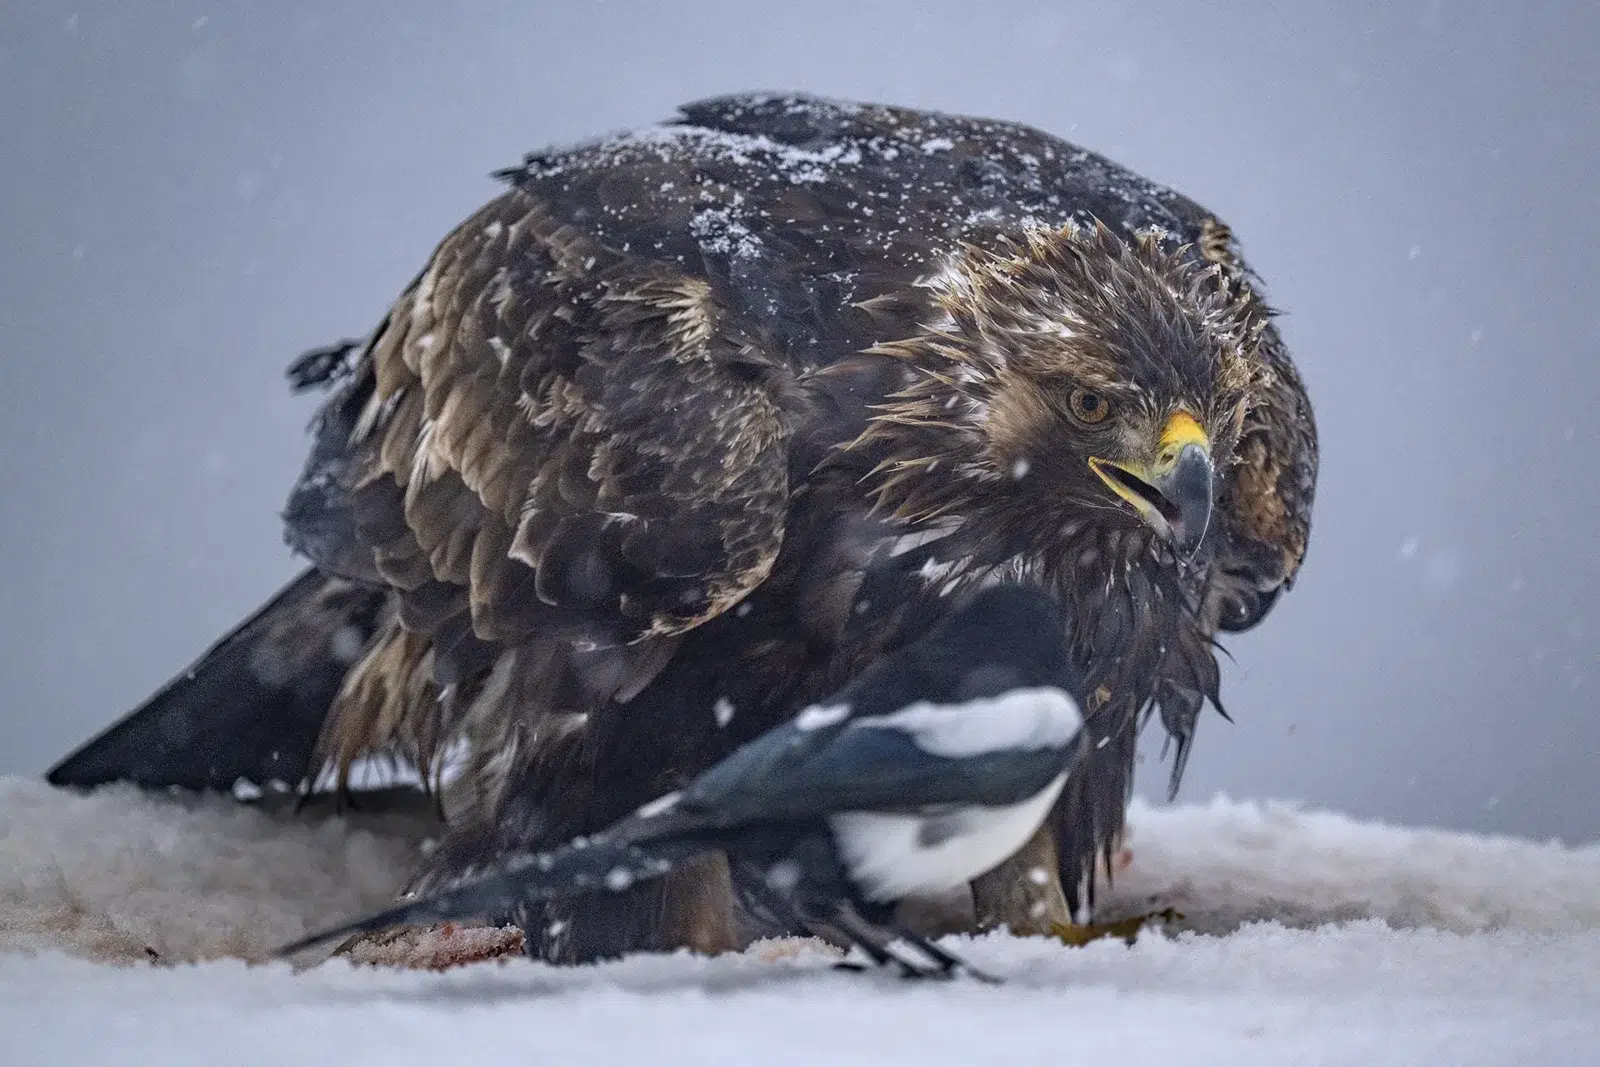
Vi började undersöka en bild med en kungsörn och en skata från Norge. I Photoshop kunde jag visa upp metadata med upphovsrättsinformation. Men en WebP-fil som vi granskade saknade inbäddade EXIF-, IPTC- och XMP-uppgifter.
Vi undersökte även en PSD-fil från mitt bildmaterial, där upphovsrättsinformationen fanns inbäddad. Det är ett positivt besked, men det är ännu inte ett fullständigt bevis för vad som hände med just den undersökta WebP-filen. För det måste vi kontrollera exakt vilka filer som hör ihop och följa hela vägen från arbetsfil till webbversion.
Metadata är mer än ett namn under bilden
För mig handlar metadata om mer än att mitt namn ska finnas med. En bra bildtext hjälper andra att förstå vad fotografiet visar, var det togs och i vilket sammanhang. För en nyhetsfotograf är det en viktig del av trovärdigheten. Och för en naturfotograf kan de där uppgifterna ge bilden en historia som inte syns i själva motivet.
Med AI-genererade och manipulerade bilder blir det också allt viktigare att kunna redovisa en bilds ursprung. IPTC och Content Credentials kan hjälpa oss, även om vanliga metadatafält inte i sig bevisar att ett fotografi är äkta.
Jag har tidigare skrivit om varför IPTC-metadata blir allt viktigare och om Content Authenticity Initiative. Nu fick jag anledning att granska mina egna rutiner lika noggrant.
Vem är skyldig? Vi vet inte än.
Just nu vet vi att en undersökt WebP-fil saknar inbäddad upphovsrättsinformation, samtidigt som en undersökt PSD-fil innehåller sådan information. Det vi ännu inte vet är exakt var i arbetsflödet uppgifterna eventuellt försvann.
Jag fortsätter därför med ett kontrollerat test av samma motiv i originalfil, arbetsfil och publicerad webbversion. När jag vet i vilket steg uppgifterna försvinner återkommer jag med resultatet. Fram till dess tänker jag inte peka ut någon skyldig.
Det vore lätt att skylla på ett program – eller på mig själv. Men efter så många år som bildjournalist vet jag bättre: först kontrollerar man fakta, sedan berättar man vad som hänt.
Det här tar jag med mig
En sak har jag redan lärt mig: det räcker inte att metadata ser rätt ut i arbetsfilen. Jag behöver också kontrollera den färdiga filen som andra faktiskt får se eller laddar ned.
Och oavsett hur den här utredningen slutar tänker jag fortsätta prata om bildtexter, upphovsrätt och bilders ursprung. För trovärdighet handlar inte om att alltid ha rätt. Det handlar också om att våga granska sitt eget arbete.
Hur gör du med dina bilders metadata?
Har du någon gång upptäckt att bildtext eller upphovsrättsinformation försvunnit? Berätta gärna i kommentarsfältet. Jag är nyfiken på andras erfarenheter – kanske kan vi lära oss något av varandra.
© Roger Vikström / RVBild
Lämna ett svar